

📌 Qui trovi da dove arriva quell’abitudine e cosa ho misurato su 1.801 immagini di 52 modelli: scrivere l’ora nel prompt la riduce, allegare il disegno del quadrante la fa quasi sparire. Nella seconda parte racconto come una prova sui generatori è diventata in due giorni uno studio pubblicato, con immagini e dati che chiunque può scaricare e ricontrollare.
Erano le 8:36 quando mi è arrivato un messaggio in privato su instagram:
“Luca posso chiederti una cosa?
Sto realizzando un servizio AI per un cliente che produce orologi ‘vintage’ perché le generazioni mi mettono sempre le ore dieci e dieci, anche se gli dico altro?”
Ho risposto così:
grazie per la meravigliosa domanda, il problema fondamentale dipende da:
I “bias” di addestramento, prova a fare una ricerca su google di orologi con le lancette, vedrai che quasi la totalità ha le lancette a 10:10
dal modello che usi (i più recenti sono più bravi ad andare contro quel bias)
e se usi o meno le reference.
Nei prossimi giorni ti mostro una cosa, mi hai dato lo spunto.
Questo pezzo è la cosa che avevo promesso di mostrare.
A gennaio Popular Science ha pubblicato un pezzo di Justin Pot con un titolo che è già una diagnosi: Why does AI suck at making clocks?, perché l’AI è così scarsa nella generazione degli orologi.
La spiegazione è semplice.
Cerca “orologio” in un motore di immagini e guarda che ore segnano le lancette: la maggior parte degli orologi analogici sta alle dieci e dieci, perché è la posa delle foto pubblicitarie. I generatori hanno imparato da quelle foto, e quindi disegnano le dieci e dieci anche quando chiedi un’altra ora.
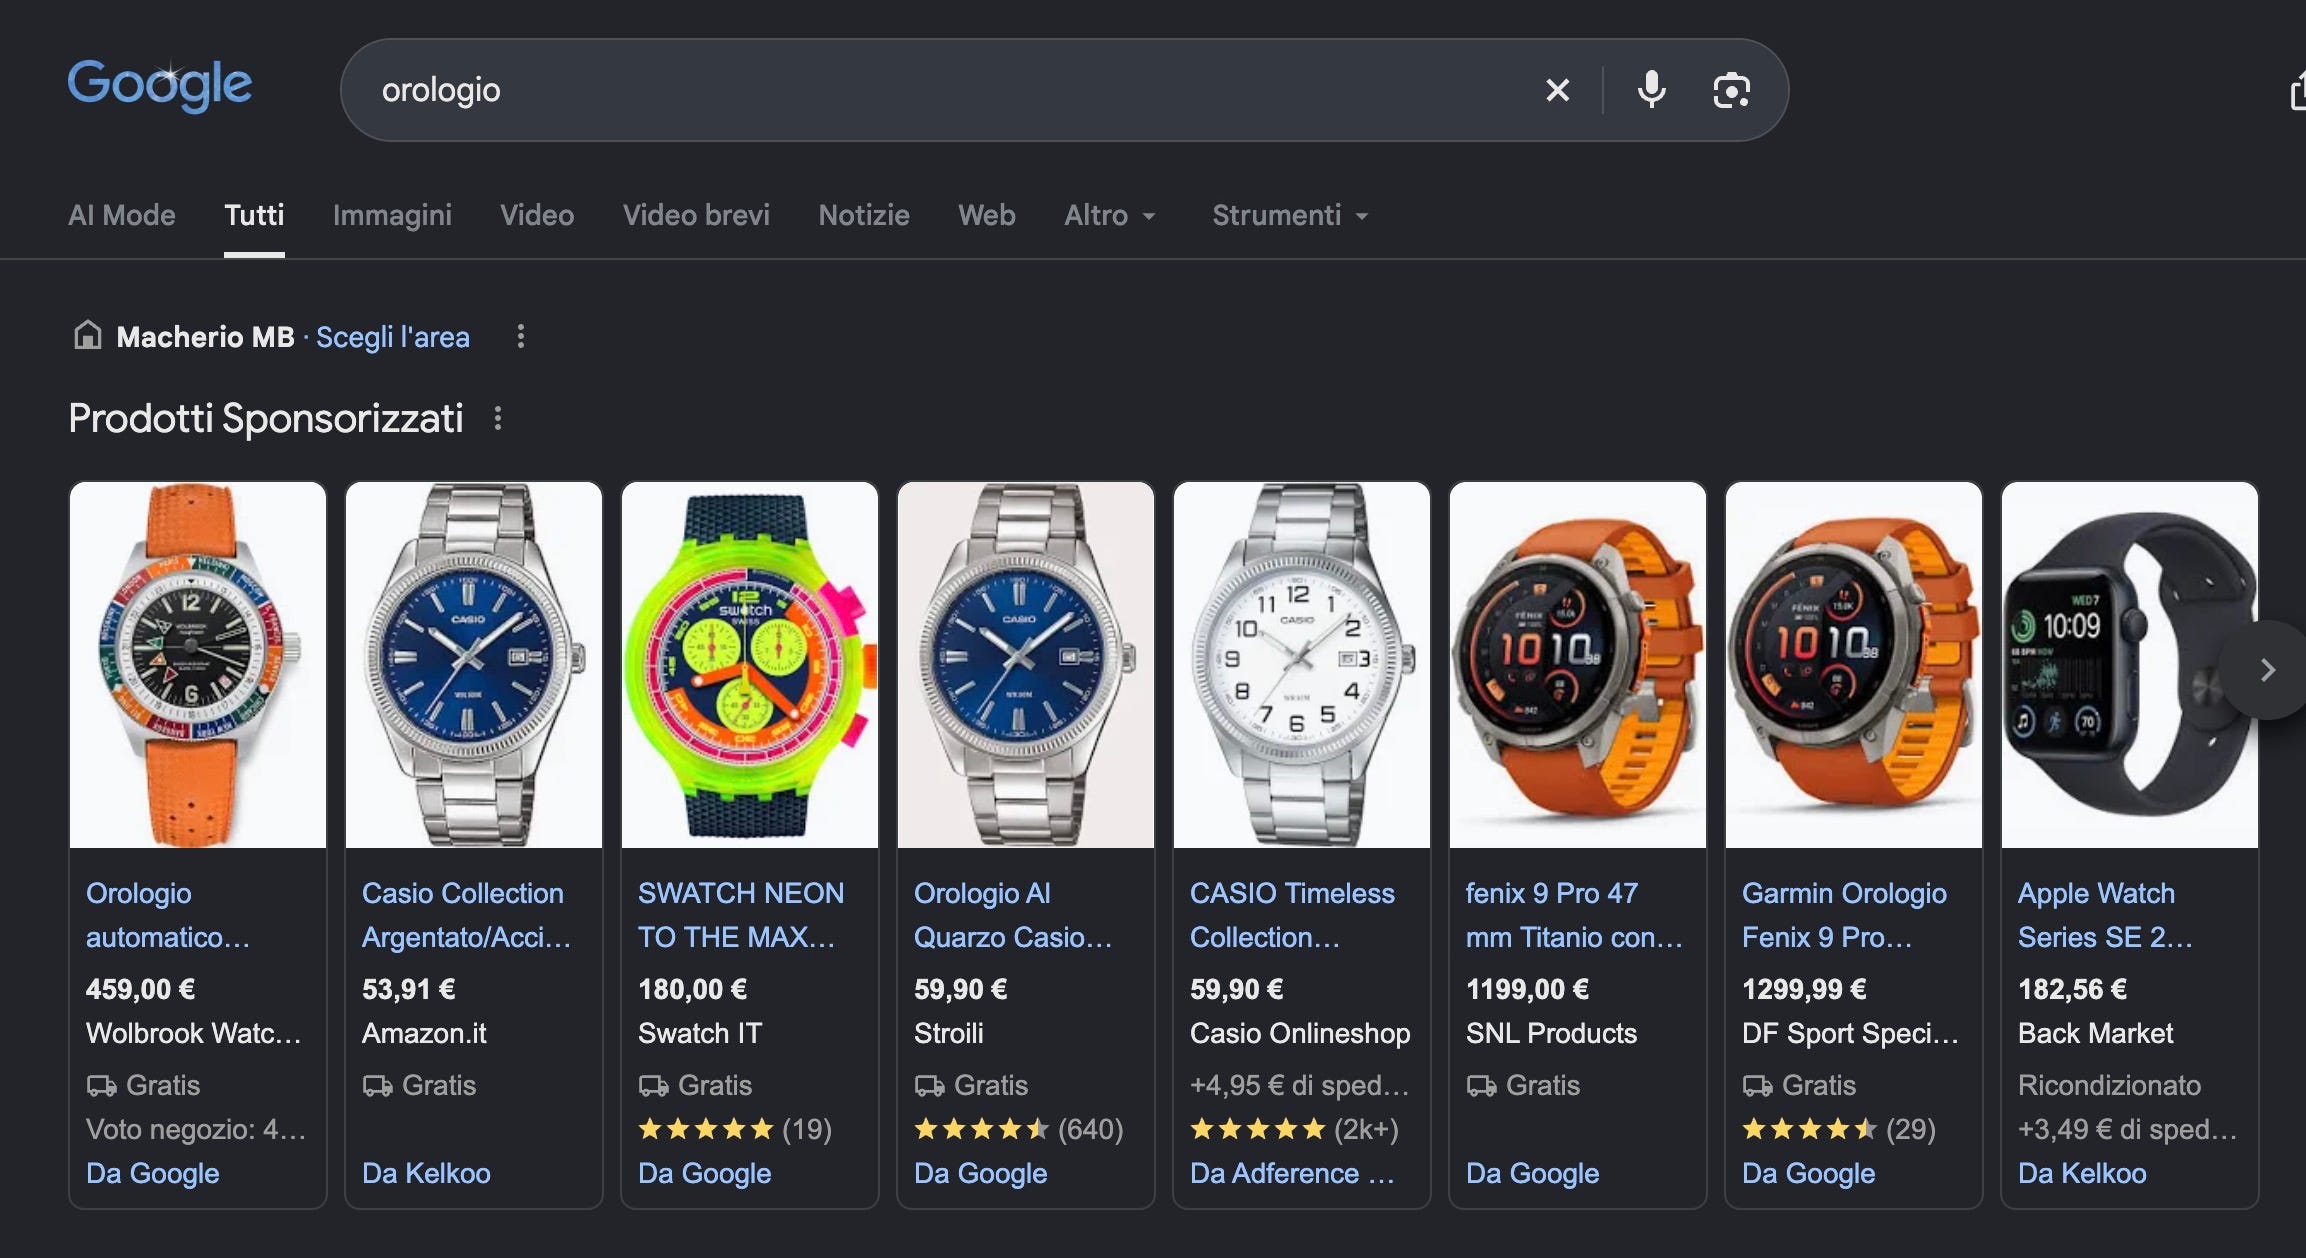
La ricerca su Google che ho consigliato l’ho fatta anch’io. Nei prodotti sponsorizzati in cima alla pagina c’erano un Rolex GMT-Master, due Submariner, un cronografo arancione e un orologio sportivo giallo e nero: cinque modelli diversi, e le lancette quasi alla stessa ora su tutti, attorno alle dieci e dieci, se guardi bene il bias è così radicato che anche le immagini di orologi digitali segnano l’ora intorno alle 10:10.
Chi fotografa prodotti lo sa da sempre: nello still life gli orologi si mettono alle dieci e dieci.
Perché proprio le dieci e dieci
La convenzione è più vecchia di quanto si pensa.
Secondo un’inchiesta del New York Times del 2008, ripresa da Kottke, Hamilton usava le 10:10 nelle pubblicità almeno dal 1926, Rolex in modo sistematico dai primi anni Quaranta, e Timex ha cominciato a passarci nel 1953, quando il modello Ben Hogan segnava ancora le 8:20 e il Marlin già le 10:10.
Oggi ogni marca ha il suo orario di casa, preciso al secondo:
Timex fotografa i suoi orologi alle 10:09:36, come ha raccontato il suo presidente Adam Gurian al Times, anche quando quella posizione copre qualche funzione,
Rolex aspetta quasi un minuto in più, alle 10:10:31.
Il caso più documentato è quello di Seiko, il perchè viene raccontato nel suo museo.
Sul sito del Museo Seiko di Ginza c’è scritto che dal 1964 i loro orologi in vetrina e in pubblicità segnano le 10:08:42, e che prima segnavano le 10:10:30.
I motivi che danno sono da fotografo: le lancette non si sovrappongono, il quadrante sembra in equilibrio, e il marchio sotto il 12 resta leggibile. Giorgio Galli, direttore del design di Timex, a NPR nel 2014 l’ha riassunta in una parola, simmetria.
Poi c’è il sorriso.
Nel 2017 Ahmed Karim e tre colleghi hanno pubblicato su Frontiers in Psychology un esperimento con 46 persone e 20 orologi fotografati alle 10:10, alle 11:30 e alle 8:20. Le foto alle 10:10 piacevano di più, e in un secondo esperimento le persone associavano le 10:10 a una faccia che sorride e le 8:20 a una faccia triste.
Sull’intenzione di comprare, però, il vantaggio sulle 8:20 non era abbastanza netto da dirlo con sicurezza: lo studio misura il gradimento, non le vendite.
E i fotografi di oggi?
Su Capturing Watches, uno studio che fotografa orologi per l’e-commerce, scrivono che cercano di stare sempre fra le 10:08 e le 10:12, salvo eccezioni. Le storie che girano sui social, le 10:10 come ora della morte di Lincoln o di Kennedy o della bomba su Hiroshima, sono leggende: Lincoln fu colpito alle 22:15, Kennedy alle 12:30, la bomba esplose alle 8:15, e Mental Floss le ha smontate una per una già nel 2009.
Il risultato di cent’anni di still life è quello che vedi nella ricerca su Google.
E qui veniamo alla risposta al messaggio iniziale, quello di instagram per intenderci.
I modelli sono stati addestrati su milioni di still life con le ore 10:10. E’ per questo che disegnano le dieci e dieci anche quando chiedi un’altra ora.
Sapere da dove arriva l’abitudine, però, non aiuta chi mi ha scritto alle 8:36. Chiede un’altra ora, si ritrova le dieci e dieci, e il servizio è per un cliente che produce orologi. A questo punto quello che serve sapere è pratico: se scrivo l’ora nel prompt, il modello la rispetta? E se non la rispetta, cosa posso fare?
Nella risposta avevo messo tre cose:
il bias di addestramento, il modello che usi e le reference.
Da dove viene il bias l’abbiamo appena visto.
Le altre due si possono misurare, ed è proprio quello che avevo misurato:
ho chiesto la stessa foto ai modelli di Magnific in quattro modi, dal prompt senza nessuna ora fino al disegno del quadrante allegato, e ho contato dove finivano le lancette.
La prova: tre orologi, tre ore, quattro modi di chiederle
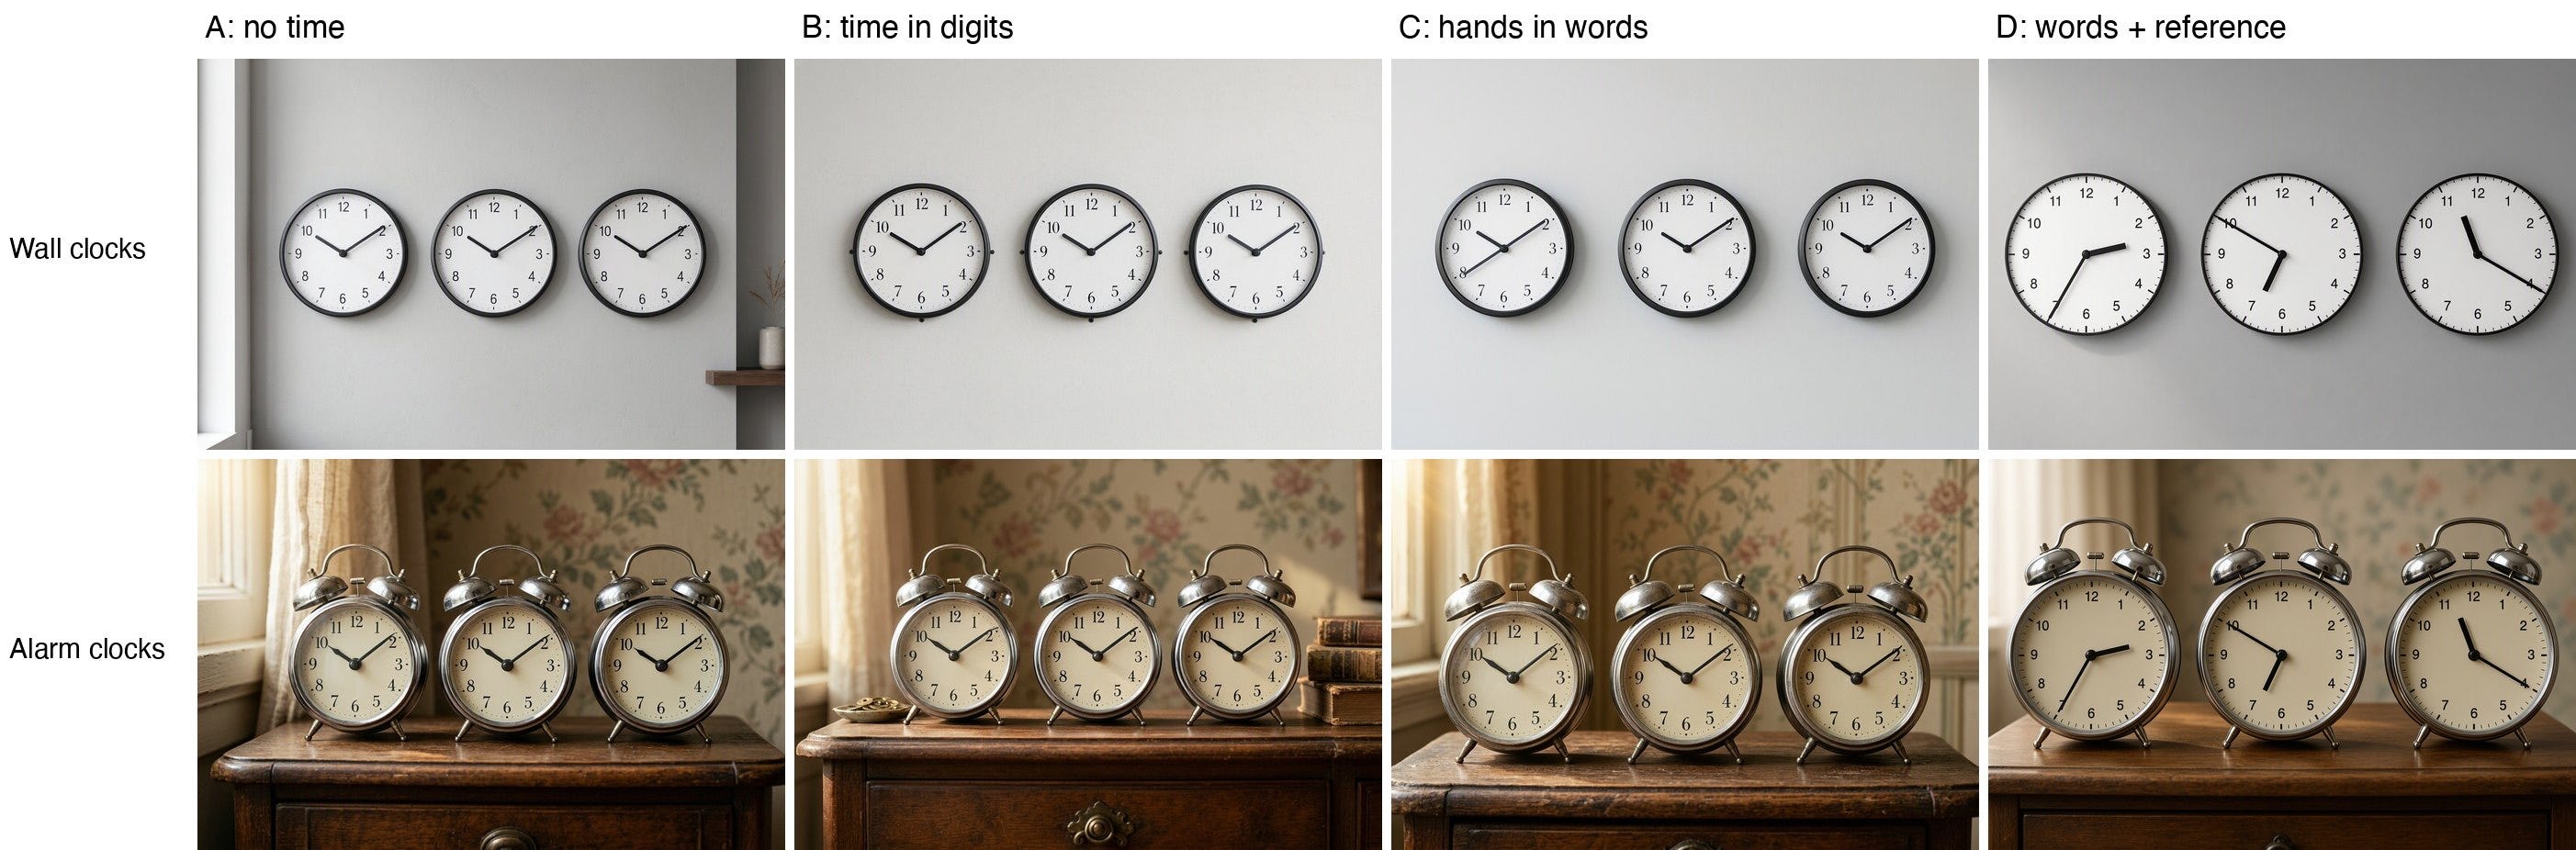
Ogni immagine contiene tre orologi identici, uno accanto all’altro, che devono segnare tre ore diverse: 2:35, 6:50 e 11:20. Le ho scelte lontane dalle 10:10 e lontane fra loro, così che un errore non si confonda con un’altra ora giusta. Da una generazione all’altra le ore cambiano di posto fra l’orologio di sinistra, quello centrale e quello di destra, perché non volevo che la posizione nella foto pesasse sul risultato.
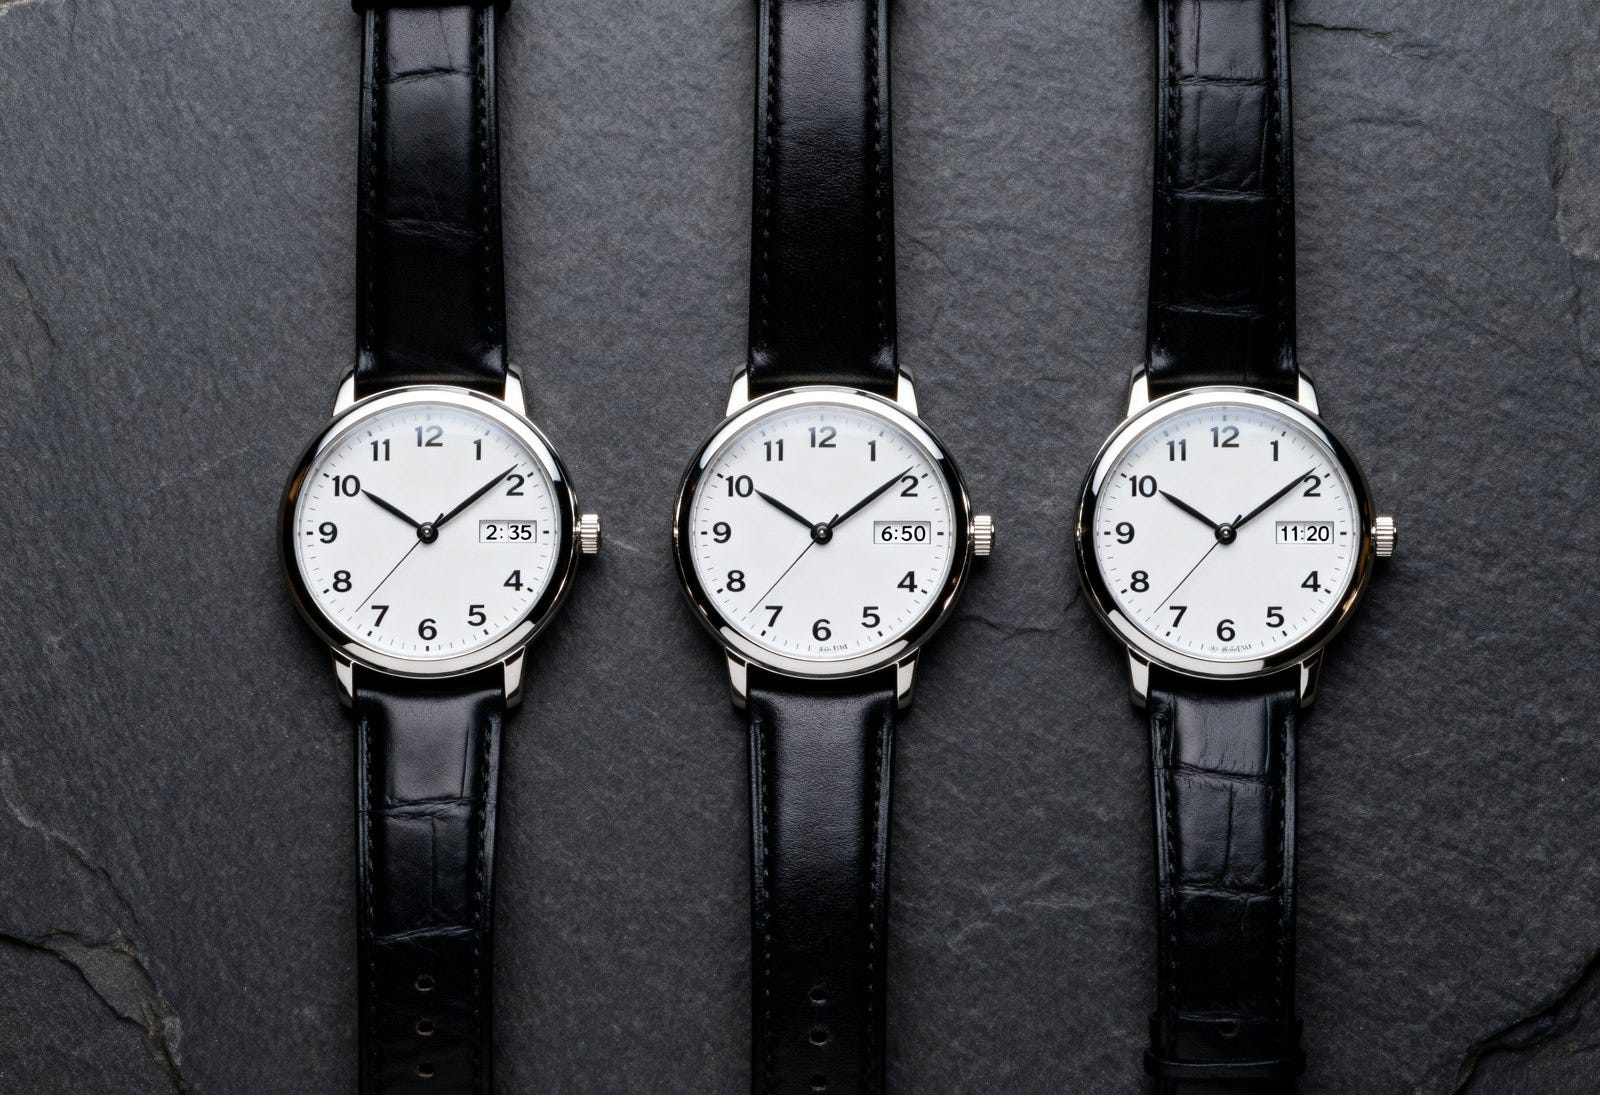
Le scene sono tre: orologi da polso fotografati dall’alto come in un catalogo, orologi da parete in un interno pulito, e le vecchie sveglie con i due campanelli su un comodino di legno.
In tutte le prove l’oggetto è descritto con le stesse parole, comprese le lancette: quella delle ore corta e spessa, quella dei minuti lunga e sottile, tutte e due sullo stesso perno. Cambia solo la riga che riguarda l’ora, in quattro modi.
Nella prima prova l’ora non la chiedo proprio, perché voglio vedere dove vanno le lancette quando nessuno dice niente.
Nella seconda scrivo l’ora in cifre, come farebbe chiunque: “Times, left to right: 2:35, 6:50, 11:20”.
Nella terza non scrivo nessuna cifra e descrivo la posizione delle lancette rispetto ai numeri del quadrante, come insegno a fare con il metodo SCHEMA: per le 2:35, la lancetta delle ore sta ai sette dodicesimi della strada fra il 2 e il 3, quella dei minuti punta esattamente sul 7.
Nella quarta tengo la stessa descrizione e ci allego un disegno, tre quadranti in bianco e nero con le lancette già nella posizione giusta, con una riga che dice al modello di usare il disegno solo per gli angoli delle lancette e di fare tutto il resto come descritto nel testo.
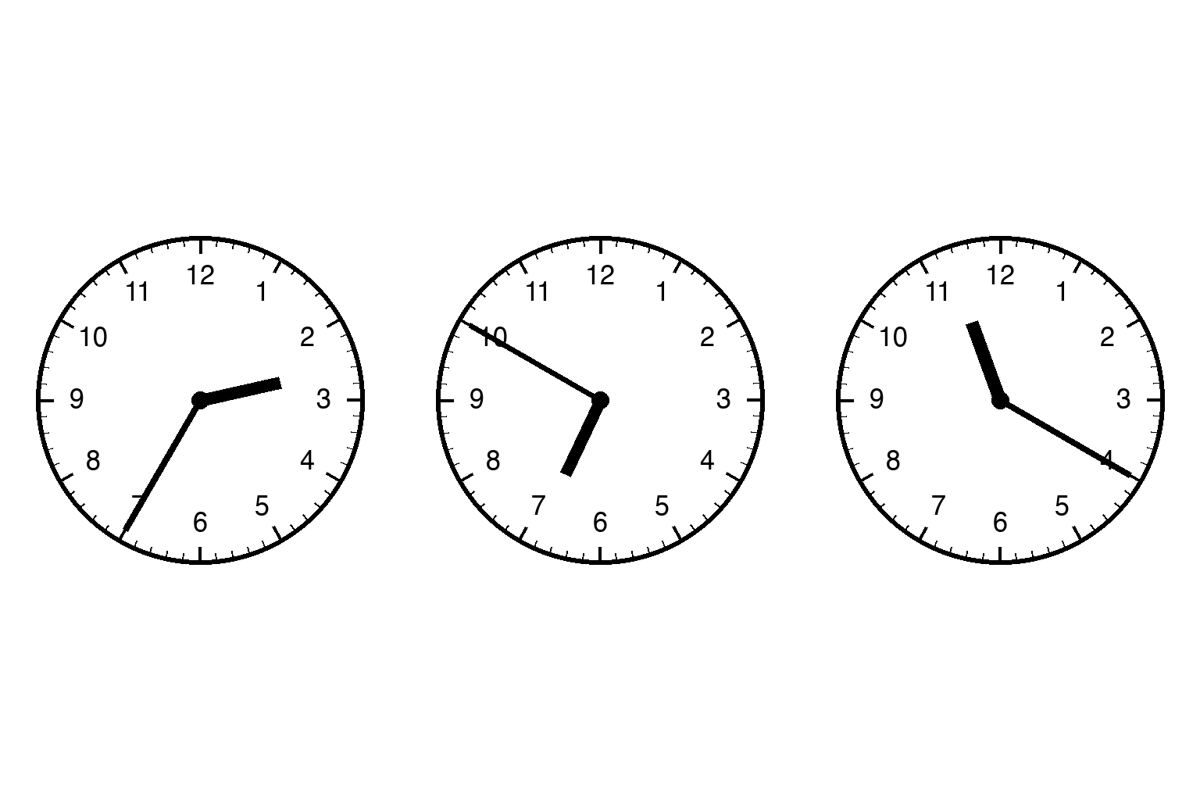
I modelli sono tutti quelli presenti dentro Magnific offre per le immagini e che accettano una richiesta di solo testo: 52. Runway l’ho dovuto lasciare fuori, perché senza un’immagine di partenza rifiuta il lavoro.
Sui 20 modelli più recenti ho fatto tutte e quattro le prove per tre giri; sugli altri 32 solo la prima, quella senza ora.
Poi ho rifatto tutto su Higgsfield, con i 12 modelli che ci sono su tutte e due le piattaforme, per sei giri, per controllare che il risultato non dipendesse da Magnific.
Alla fine le immagini sono 1.801, ognuna con tre orologi da leggere.
Chi ha guardato le lancette
Leggere 5.385 quadranti a mano non era possibile, e farli leggere a un solo modello sarebbe stato rischioso, perché ClockBench, un test pubblicato a settembre 2025, ha mostrato che il miglior modello leggeva l’ora giusta nel 13,3% dei casi, contro l’89,1% delle persone.
E’ vero che siamo a fine 2026 e che i modelli nella parte Vision hanno fatto passi da gigante, ma ho deciso:
Di fare copie di tutte le immagini, le ho rinominate con un codice casuale e le ho mescolate, in modo che chi le leggeva non sapesse quale modello le avesse fatte né che ora avrebbero dovuto segnare.
Due lettori agentici diversi, GPT-6.1 Sol di openAI e Opus 5.5 per Claude, hanno guardato ogni immagine e scritto dove puntava ciascuna lancetta, non l’ora: l’ora l’ha calcolata poi un programma, con regole fisse.
Quando i due lettori non erano d’accordo, l’immagine passava a un terzo, Gemini, e decideva la maggioranza. I quadranti ancora in dubbio dopo i tre lettori sono stati 20, li ho guardati io, uno per uno, scrivendo prima l’ora e poi i minuti.
Erano i casi brutti dove i modelli li hanno generati proprio male: orologi con tre lancette invece di due, quadranti con una sola lancetta visibile, una sveglia in cui le ore non si leggevano proprio.
In quei casi anche un occhio umano esita, e mi è sembrato giusto che la decisione finale fosse mia e scritta, con il motivo accanto. I modelli di OpenAI e Claude sono stati d’accordo sul 96% dei quadranti nello studio principale e sul 97% nella replica.
Se non chiedi niente
Senza nessuna ora nel prompt, il 67% delle immagini dei 52 modelli ha tutti e tre gli orologi alle 10:10. Due immagini su tre. Se conti i singoli quadranti invece delle immagini, si sale al 72%. Se adesso ti viene in mente la pubblicità di un orologio, sai già che ore segna.
L’abitudine però non è di tutti allo stesso modo. Su Higgsfield, Nano Banana Pro ha messo alle 10:10 tutti i 54 quadranti che ha disegnato, senza una sola eccezione. Ideogram 4.5, nelle stesse condizioni, l’ha fatto 2 volte su 54, e GPT 2.5 Sunburst 8 volte. Quindi chi dice che “l’AI fa sempre le 10:10” ha ragione sulla media e torto su alcuni modelli, ed è un’informazione utile se devi scegliere con quale lavorare.
Fin qui, niente di sorprendente: è la conferma di quello che tutti abbiamo visto.
Scrivere l’ora aiuta poco
Quando scrivi l’ora in cifre, sui 20 modelli recenti di Magnific le immagini con tutti e tre gli orologi alle 10:10 scendono dal 69% al 21%. Sembra una vittoria, e in parte lo è. Ma le immagini con tutti e tre gli orologi giusti sono appena il 34%: in due immagini su tre almeno un orologio sbaglia ancora, alle 10:10 o in qualche altro modo.
C’è un dettaglio del primo giro di prova che secondo me spiega il problema meglio di qualunque teoria. Seedream 4 4K, a cui avevo chiesto 2:35, 6:50 e 11:20, ha disegnato tre orologi con il datario, e dentro la finestrella del datario ha scritto proprio “2:35”, “6:50” e “11:20”.
Le lancette, intanto, segnavano le 10:10 su tutti e tre.
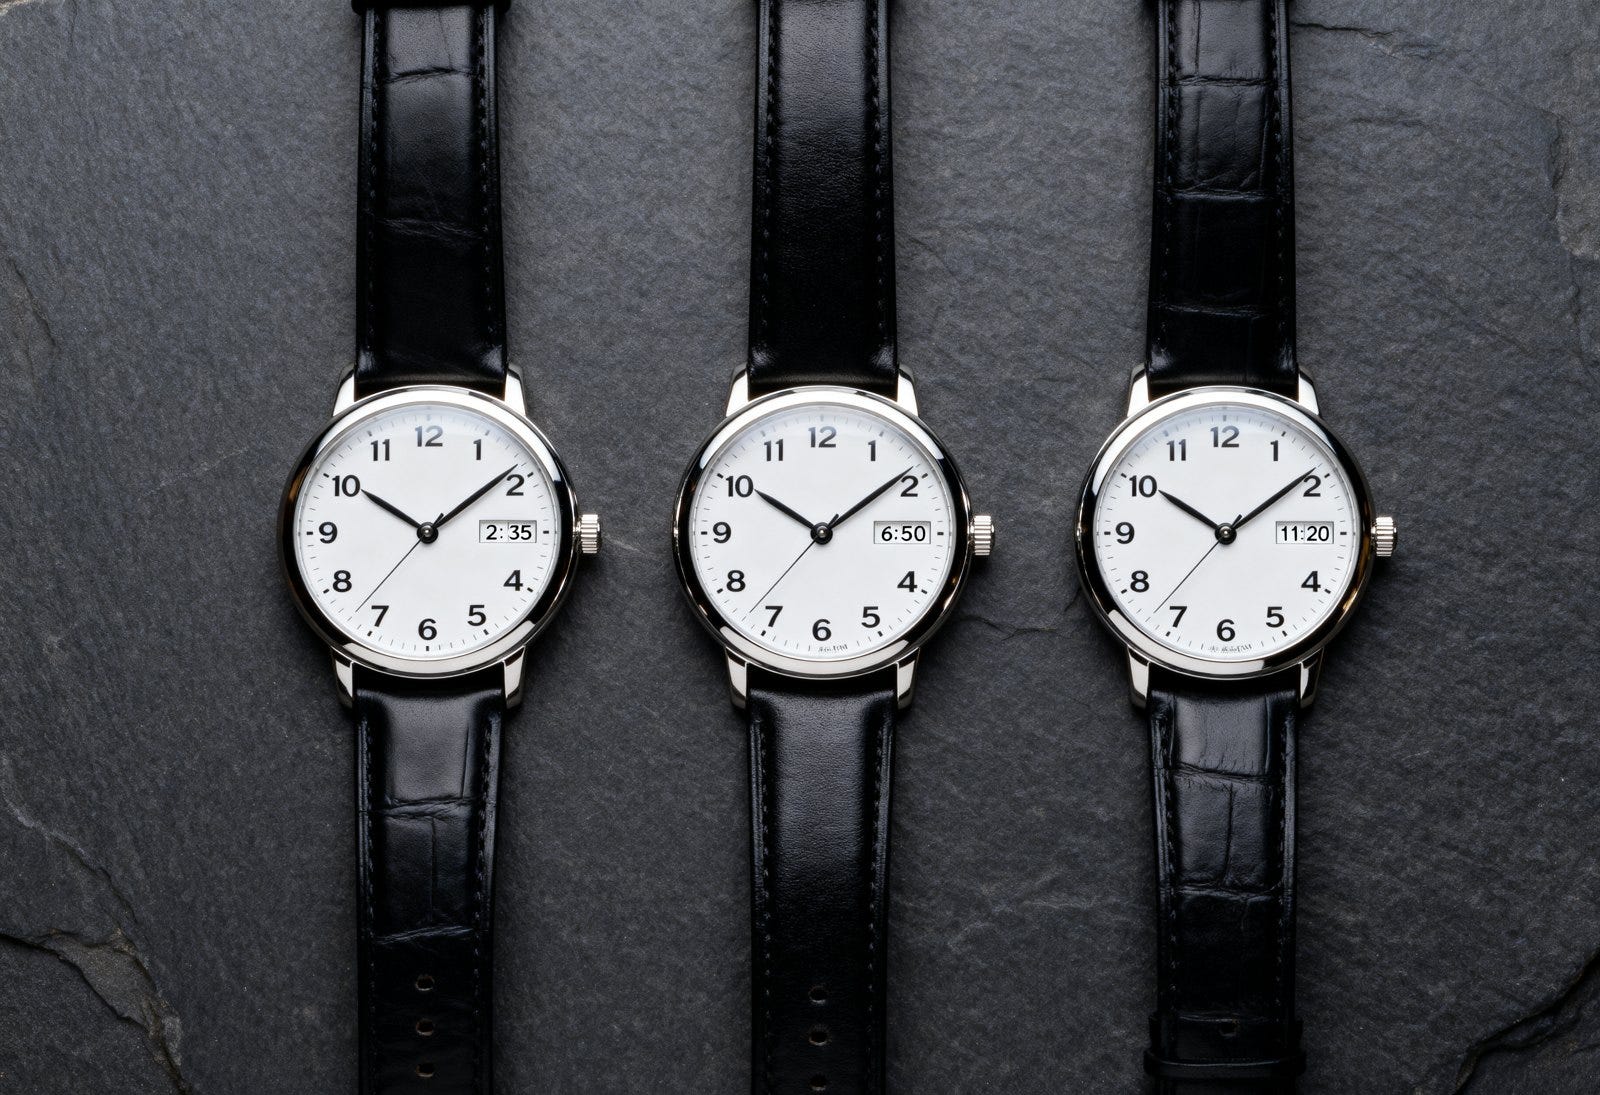
Il modello, a quanto pare, ha capito la richiesta: sa che deve comparire “2:35”. Quello che non sa fare è trasformare quella scritta nella posizione di due lancette, e allora la scrive dove può, come testo, e lascia le lancette dove le ha sempre viste. Non è un caso isolato: nel primo giro di prova è successo in sei immagini, con modelli diversi.
L’avevo scritto ad agosto in L’AI non sbaglia mai un’immagine: il generatore produce l’immagine più probabile date le parole che gli dai, e in questo senso non sbaglia mai. E l’immagine più probabile di un orologio, per un modello che ha visto milioni di pubblicità, è un orologio alle dieci e dieci.
E allora descrivo le lancette, come insegno a fare
Qui il risultato tocca il mio metodo.
La terza prova, quella con le lancette descritte a parole senza cifre, è la regola che insegno nei corsi con il metodo SCHEMA: non nominare le cose, descrivile per come sono costruite. Sui 20 modelli recenti ha portato il 30% di immagini con i tre orologi giusti, contro il 34% dell’ora in cifre. La differenza è piccola e potrebbe essere caso: descrivere le lancette non ha battuto le cifre. Se conti i singoli quadranti invece delle immagini, le due prove sono pari: 46% contro 43%.
C’è anche un errore nuovo che le parole portano con sé. Quando descrivi le lancette, alcuni modelli le scambiano: mettono la lancetta corta dove doveva andare quella lunga e viceversa, come se avessero capito i due angoli ma non a chi appartengono. Con l’ora in cifre succede nel 5% dei quadranti, con la descrizione a parole nell’8%. È un numero piccolo, ma dice che aggiungere parole aggiunge anche occasioni per confondersi.
Uno che insegna un metodo, a vederlo pareggiare con l’ora scritta in cifre, dovrebbe preoccuparsi.
Il mio sentimento è stato di soddisfazione e tranquillità. Il Mio metodo SCHEMA si basa in parte su quello che dici al modello, la descrizione per costruzione che ho appena misurato, ma si basa anche sull’uso delle reference nel modo corretto. La quarta prova è proprio quella parte del metodo.
Su un’abitudine così forte la descrizione da sola non è bastata, e saperlo mi serve. Quando conosci un bias di questa forza sai esattamente cosa fare e come farlo: usi le parole per progettare il disegno, e poi il disegno lo alleghi.
Il disegno
Con la stessa descrizione e il quadrante disegnato allegato, le immagini con tutti e tre gli orologi giusti salgono al 75%.
Rispetto all’ora in cifre sono 37 punti in più. Anche facendo il calcolo nel modo più prudente, cioè ricampionando i modelli invece delle singole immagini, la forbice più bassa che esce è di 21 punti. Le immagini con tutti e tre gli orologi alle 10:10 quasi spariscono: il 2%. Detto senza percentuali, tre volte su quattro esce quello che hai chiesto.
Il caso più netto è MAI Image 2.5, il modello di Microsoft. Senza ora, con l’ora in cifre e con le lancette descritte a parole ha messo alle 10:10 tutti i 27 quadranti di ogni prova, come se la riga sull’ora non esistesse.
Con il disegno allegato ha fatto giuste tutte e nove le immagini.
Lo vedi nella prima figura di questo pezzo: stessa scena, stesso modello, e l’unico cambiamento è un disegno.
La stessa storia, con numeri un po’ più bassi, vale per altri modelli.
Seedream 5 Lite passa da zero a nove immagini giuste su nove,
Flux.3 e Ideogram 4.5 da zero a sette, e Ideogram su Higgsfield arriva a 17 su 18.
All’opposto ci sono modelli che il disegno non salva: Krea 2 resta a zero,
Nano Banana Pro arriva a una sola immagine giusta su nove.
E poi ci sono GPT 2.5 Flare e Sunburst, che hanno fatto giusto tutto in tutte e tre le prove con l’ora, anche senza disegno: con loro il problema quasi non si pone.
La replica su Higgsfield dice la stessa cosa. Sui 12 modelli in comune Higgsfield dà il 54% di immagini giuste con l’ora in cifre, il 50% con le lancette a parole e l’81% con il disegno; gli stessi modelli su Magnific danno 52%, 45% e 80%. Su due piattaforme diverse il quadro è lo stesso.
Ho chiamato lo studio “le reference per battere i bias” proprio per questo.
Una reference, cioè un’immagine allegata alla richiesta, arriva dove le parole non arrivano, ed è lo stesso principio di cui ti parlavo a maggio in Google trasforma i tuoi video in qualsiasi immagine tu voglia: la direzione la dai anche con quello che porti al modello, oltre che con quello che gli scrivi.
Come lo uso da domani nel lavoro
Il disegno non deve essere bello. Il mio era tre cerchi con i numeri e due lancette per cerchio, fatto con un programmino in pochi secondi; puoi farlo con Keynote o con una matita e una foto del telefono.
Quello che conta è che le lancette siano dove le vuoi tu, e che il modello sappia che di quel disegno deve prendere solo la posizione. Il mio aveva i numeri da 1 a 12 su fondo bianco, una lancetta corta e spessa per le ore e una lunga e sottile per i minuti, e i quadranti nello stesso ordine degli orologi da generare, da sinistra a destra. Quando nella scena gli orologi sono tre, i quadranti disegnati sono tre: un disegno solo per tutti avrebbe lasciato al modello il dubbio su quale ora mettere dove. La riga che ho usato nel prompt è questa, e funziona anche tradotta: “usa il disegno allegato solo per stabilire gli angoli delle lancette e quale orologio è quale; per il design, la scena e lo stile fotografico segui il testo”.
Il disegno porta con sé anche il suo aspetto: nella quarta prova alcuni modelli hanno reso i quadranti più piatti e semplici, simili al mio schema. Lo studio misura l’effetto della reference nel suo insieme, aspetto compreso, e lo dice chiaramente. Questo effetto collaterale diventa un problema quando non sai come usare al meglio un modello, come scrivere il prompt e come usare le reference. Se ti serve un orologio di un design preciso, disegni la reference il più possibile vicina a quel design, oppure parti da una foto vera del prodotto con le lancette spostate in Photoshop. È quello che insegniamo con Marianna Santoni al corso Intelligenza artificiale per immagini professionali.
Il 17 e 18 ottobre siamo in aula a Milano. Due giorni con Marianna Santoni su modelli, prompt e reference per le immagini professionali, con un webinar prima, il 12 ottobre, e uno dopo, il 17 novembre.
Date, programma e iscrizioni
L’altra cosa pratica riguarda la scelta del modello. Se lavori spesso con dettagli come questi, la domanda “qual è il modello migliore?“ ha una risposta solo se la fai sul tuo lavoro: per gli orologi, oggi, GPT 2.5 segue il testo e Nano Banana Pro no, e lo scopri in dieci minuti con tre orologi e tre ore.
Questo perchè è una questione di modernità, i modelli più recenti seguono meglio le istruzioni cercando di non farsi condizionare dai BIAS
E vale oltre gli orologi?
Lo studio ha misurato solo gli orologi, ma la logica vale su qualsiasi altri Bias coninvolti.
Altri difetti famosi dei generatori, come il bicchiere di vino che non vuole riempirsi fino all’orlo e su cui Rapidata ha scritto un’analisi a luglio 2025, hanno la stessa forma: un’immagine vista milioni di volte che vince sulla tua richiesta.
Il 7 ottobre questa era una prova da articolo. La mattina dell’8 era un archivio pubblico con un codice permanente e un paper inviato ad arXiv, il sito dove i ricercatori pubblicano i loro lavori prima delle riviste. Ti racconto come ci sono arrivato, perché si può rifare.
Dalla prova al paper in poco più di un giorno
Tutto è partito da una frase che ho scritto a Claude guardando i primi risultati:
“bello questo test, possiamo anche scrivere uno studio da pubblicare su arXiv?”.
La risposta è stata sì, a una condizione: prima di spendere altro, il metodo andava rivisto da qualcuno che non l’aveva scritto.
Il revisore l’ha fatto Sol, il modello di OpenAI che uso per le critiche, che ha il pregio di non darti ragione per gentilezza. Ha trovato due cose che a me erano sfuggite.
Nel primo giro la forma delle lancette era descritta solo nella prova a parole, quindi le prove non erano davvero confrontabili. E un vincolo diceva “nessun testo sul quadrante”, che a rigore escludeva anche i numeri.
Ho rifatto i prompt e ho declassato quel primo giro a prova esplorativa.
Le 156 immagini del pilota sono finite nell’archivio come pilota, e lo studio è ripartito da capo.
Poi la generazione, la sera del 7: sei aiutanti che lanciavano le richieste su Magnific in parallelo, un registro di ogni immagine con il suo identificativo, e su Higgsfield la replica, da finire prima del 22 ottobre, quando scade il mio abbonamento (che non rinnoverò).
In crediti, lo studio su Magnific è costato 64.338, più 13.533 per il primo giro finito nell’archivio come pilota; la replica su Higgsfield circa 1.126.
La regola che ho tenuto per tutta la notte è che nessun numero si scrive a mano. Tutte le cifre del paper escono da un programma che legge i verdetti finali, e insieme ai dati ho pubblicato un secondo programma che rifà ogni conto partendo dalle letture grezze dei tre lettori.
L’ho fatto girare su una cartella vuota, come farebbe un estraneo che scarica tutto: ricostruisce tutti i 5.385 verdetti senza una differenza.
Di chi sono le immagini, e dove finiscono
Prima di pubblicare le immagini ho letto i termini d’uso di Magnific e di Higgsfield, e qui c’è una cosa che vale per chiunque usi questi strumenti per lavoro.
Le immagini generate con un abbonamento a pagamento sono tue: Magnific te le cede, Higgsfield dichiara di non rivendicarle, e i diritti restano anche quando l’abbonamento scade.
Però tutte e due vietano di usarle per addestrare altri modelli, e Higgsfield vieta anche di permettere a terzi di farlo.
Una licenza aperta classica, di quelle che dicono “fatene quello che volete”, avrebbe permesso proprio questo.
Così le immagini sono pubbliche con una licenza scritta apposta: uso libero, anche commerciale, con citazione, ma vietato usarle per addestrare modelli. I dati, i prompt e le letture sono sotto una licenza aperta normale, e il codice pure. La licenza commerciale ti dà la proprietà, ma i divieti scritti nello stesso contratto restano, e conviene saperlo prima di regalare un archivio di immagini a internet.
L’archivio è su Zenodo, il deposito pubblico gestito dal CERN dove i ricercatori mettono dati e software. Ogni scheda riceve un DOI, un codice permanente che punta sempre allo stesso contenuto anche se domani cambiano i siti: quello di questo studio è 10.5281/zenodo.23224681. Dentro ci sono tutte le 1.801 immagini, i prompt esatti, le letture di ogni lettore, i verdetti e il programma che rifà i conti.
Su arXiv invece c’è il paper. Ho scoperto un paio di cose che magari ti servono, se un giorno ci pubblichi qualcosa.
Oggi arXiv concede due invii al mese per account, perché ne riceve troppi.
Il controllo automatico dei file mi ha proposto di cancellare alcune delle tabelle, perché non capiva come le richiamavo: se avessi accettato, il paper sarebbe uscito senza tre tabelle. Le caselle erano già spuntate, e bastava un clic distratto. E il campo “External DOI” serve per la versione dello stesso articolo pubblicata su una rivista: il codice dell’archivio dei dati lì non va.
L’idea, le scelte e le decisioni sui casi dubbi sono mie.
Il lavoro pesante l’hanno fatto i miei agenti: Claude ha scritto il codice, organizzato l’archivio e steso il paper, Sol ha rivisto il metodo e criticato il paper due volte, Gemini ha deciso i disaccordi. Nel paper c’è una sezione apposta che lo dichiara, come chiedono sia Zenodo sia arXiv.
Tre cose che faccio da domani
Quando un dettaglio deve essere esatto, un orologio, una mano, una posa, allego un disegno della configurazione invece di riscrivere il prompt per la quinta volta.
Prima di scegliere un modello per un lavoro con un dettaglio critico, lo provo su tre esempi con una risposta giusta e una sbagliata che si vedono a occhio, come i tre orologi: dieci minuti risparmiano un pomeriggio.
A chi mi ha scritto alle 8:36 rispondo con un disegno: tre quadranti con le lancette dove le vuole il suo cliente, da allegare alla prossima generazione. E quando sfoglio una pubblicità di orologi guardo che ore sono: sono sempre le 10:10, e adesso so quanti disegni servono per farle cambiare a una macchina. Uno.
Luca
Articoli correlati
L’AI non sbaglia mai un’immagine, ed è esattamente questo il suo limite (10 agosto 2026)
Google trasforma i tuoi video in qualsiasi immagine tu voglia, ed è solo l’inizio (29 maggio 2026)
Le stesse domande che rendono una foto professionale rendono un prompt efficace (24 luglio 2026)
“Qual è il modello migliore?” è la domanda che ti tiene fermo (11 giugno 2026)
5,5 milioni di persone hanno smontato un Monet originale credendolo AI. L’AI non è il problema, sono i tuoi bias (16 maggio 2026)
Fonti
Justin Pot, Why does AI suck at making clocks?, Popular Science, 10 gennaio 2026
NPR, It’s 10:10. Do You Know What Time That Is?, 22 settembre 2014
Kottke, At 10:10, a watch smiles, 4 dicembre 2008 (riprende il New York Times del 28 novembre 2008)
Hodinkee, Science Says 10:10 Hands In Watch Ads Are A Subliminal Soft Sell, 25 giugno 2022
Capturing Watches, Omega’s role in the 10:10 tradition, 17 novembre 2024
Mental Floss, Why is 10:10 the default setting for clocks and watches?, 2009
Daniil Pyatko, Fine-Tuning Stable Diffusion to Generate Full Wine Glasses, Rapidata, 9 luglio 2025
Luca Cazzaniga, It’s Always 10:10, archivio dei dati su Zenodo, 8 ottobre 2026